La misma cara en cada toma: personajes consistentes con Seedance 2.5
Si tu personaje cambia de cara, de ropa o de luz en cada video, el problema casi nunca es el modelo: le estás pidiendo al texto algo que solo una imagen puede fijar. Esta guía explica el método que usamos en una serie completa generada con IA, paso a paso, con la plantilla de prompt lista para copiar.
El problema: misma descripción, otra cara
Hicimos la prueba: el mismo prompt de solo texto, tres generaciones seguidas. El texto pedía «un coronel de 55 años, canoso, traje gris oscuro, camisa blanca y corbata negra, mirada dura, en una oficina de cristal de noche». Salieron tres personas distintas, y en dos de ellas el traje se convirtió en uniforme militar.
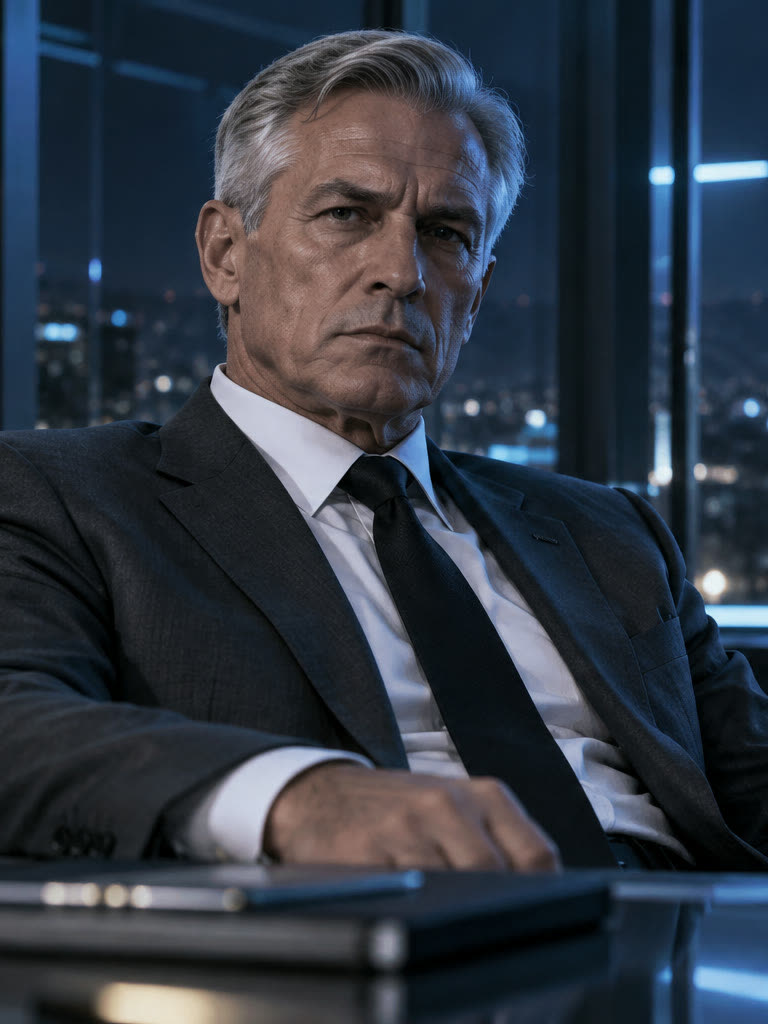
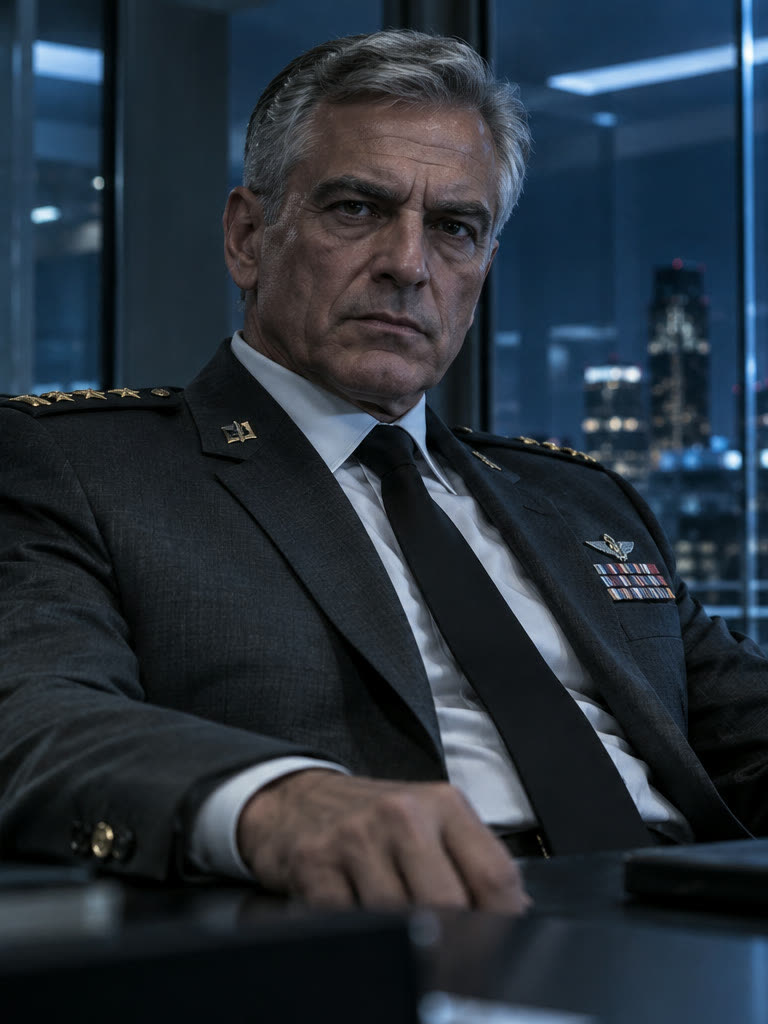
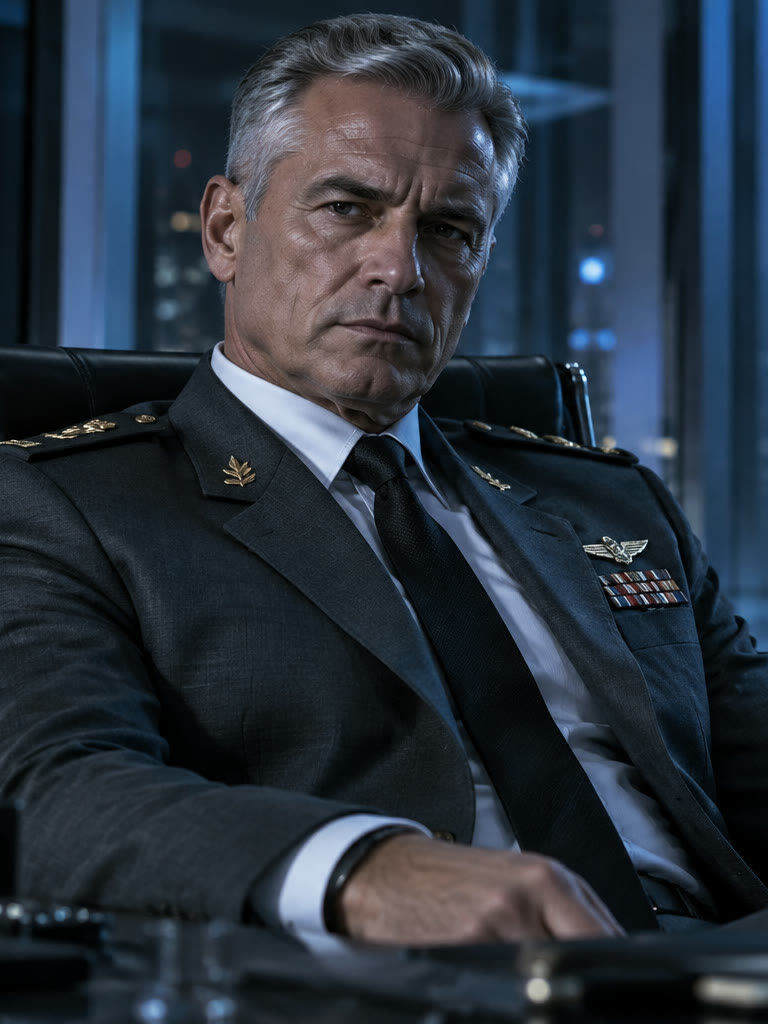
Si cada toma de tu historia sale así, el espectador deja de creer que es el mismo personaje y la historia se cae.
Por qué pasa
Un modelo de video inventa todo lo que no le muestras. Las palabras dejan huecos enormes: «canoso» admite mil cortes de pelo, «mirada dura» mil caras. En cada generación el modelo rellena esos huecos de otra forma. Escribir más adjetivos no lo arregla: cada palabra nueva abre otra interpretación.
Lo que sí elimina la ambigüedad es una imagen: una cara concreta, una ropa concreta, una luz concreta. Por eso el método cambia el papel del texto: la imagen dice quién y dónde; el texto solo dice qué hace.
El método en una frase
Una imagen del personaje + una imagen de la escena, nombradas en el prompt, y cada toma empieza en el último cuadro de la anterior. Son cuatro pasos:
| Paso | Qué preparas | Qué fija |
|---|---|---|
| 1 | Imagen del personaje | Cara, pelo, cuerpo y ropa |
| 2 | Imagen de la escena | Escenario y sus elementos, iluminación y lugar de cada personaje |
| 3 | Prompt con @Image | Que el modelo use esas imágenes y el texto solo describa la acción |
| 4 | Último cuadro de la toma anterior | Que la siguiente toma continúe sin saltos |
Paso 1 · La imagen del personaje
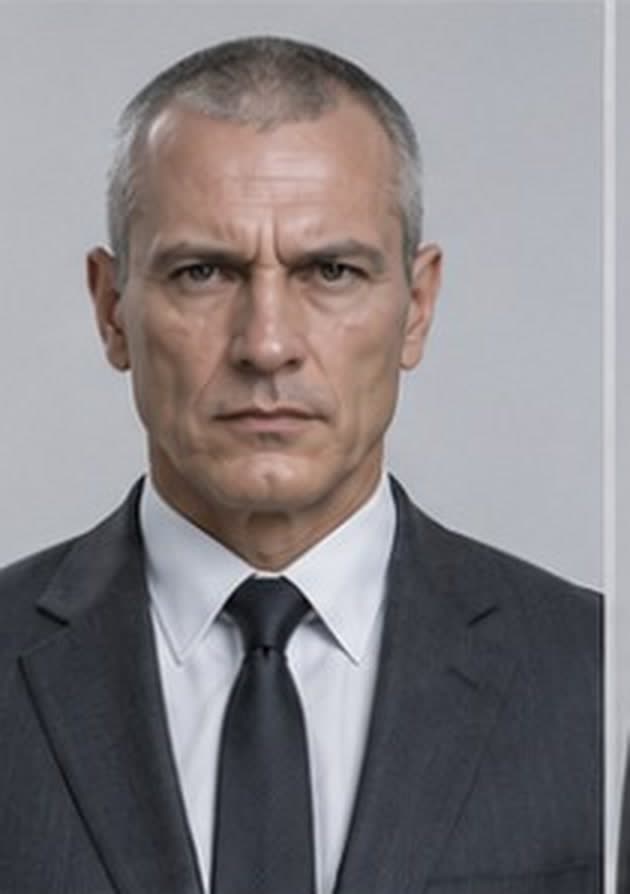
Es la identidad del personaje. Genérala una vez (en ChatGPT, Midjourney o el generador de imágenes que uses) y úsala en todas sus tomas.
- De frente y a la altura de los ojos. El modelo necesita ver la cara completa; un perfil o un contrapicado deja partes por inventar.
- Fondo liso y luz neutra. Si el retrato trae un fondo o una luz dramática, el modelo puede copiarlos a todas las tomas.
- Con la ropa de la escena. La ropa también es identidad. Si el personaje se cambia de ropa en la historia, haz otra imagen con la ropa nueva; no se lo pidas al texto.
- Una sola imagen por personaje y por vestuario. Dos retratos parecidos del mismo personaje confunden al modelo.
- Opcional: una hoja de personaje (frente, 45°, perfil y espalda) ayuda en tomas de lado o de espaldas.
Paso 2 · La imagen de la escena
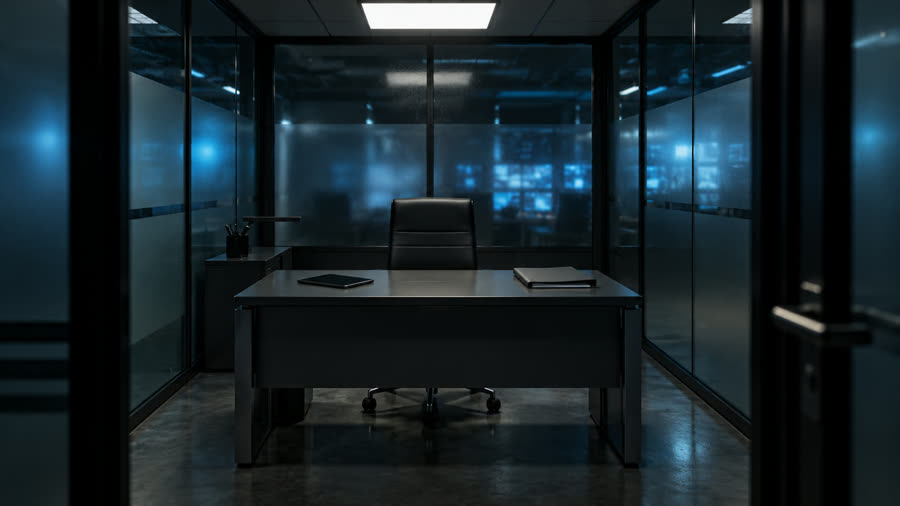
La imagen del personaje fija quién; la de la escena fija dónde y cómo se ve. Debe mostrar:
- El escenario y sus elementos: muebles, objetos y su posición (el escritorio, la silla, la tablet). Si un objeto aparece en la historia, ponlo aquí.
- La iluminación: la hora del día, el color y de dónde viene la luz. Es lo que más cambia entre tomas si no se fija.
- El sitio de cada personaje: si hay varios, quién está dónde y cómo va vestido. Así nadie cambia de lugar ni de ropa entre tomas. Esta versión con los personajes en su sitio es la que llamamos imagen de reparto.
Haz una imagen de escena por cada lugar de tu historia y reutilízala en todas las tomas que pasan ahí.
Paso 3 · Referencias en el prompt
En Seedance 2.5 (nosotros lo usamos en seevio.ai, pestaña Reference To Video) subes las imágenes como materiales de referencia y las nombras en el prompt escribiendo @: el menú inserta @Image1, @Image2… en el orden en que las subiste.
- Sube primero la imagen del personaje y después la de la escena.
- En el prompt, di qué es cada referencia y qué debe tomar de ella («su cara, su pelo y su ropa»; «el lugar y la luz»).
- Al texto déjale solo la acción, por tramos de tiempo y con verbos: «De 0 a 4 s: camina hacia la ventana».
- No vuelvas a describir la cara ni la ropa: si el texto dice algo distinto a la imagen, el modelo duda y mezcla.
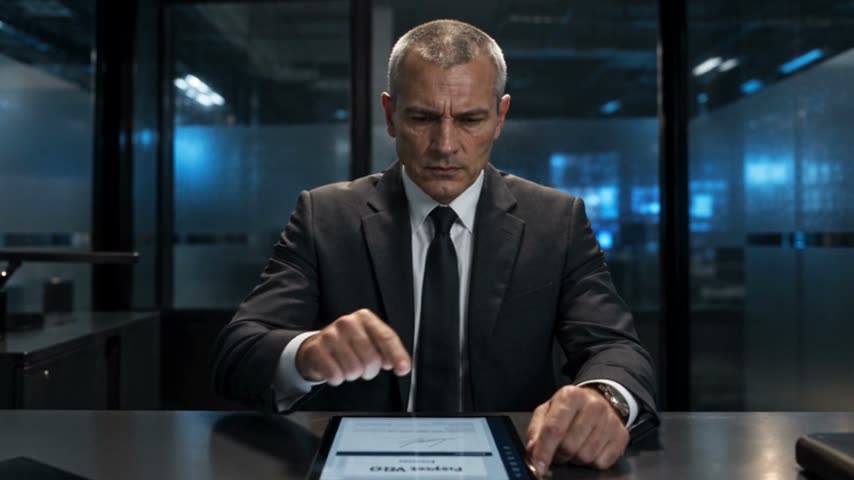
Paso 4 · Encadenar tomas por el último cuadro
Aunque la cara sea la misma, dos tomas generadas por separado no empatan: cambian la pose, el encuadre o la posición. La solución: el último cuadro de un clip es el primer cuadro del siguiente.
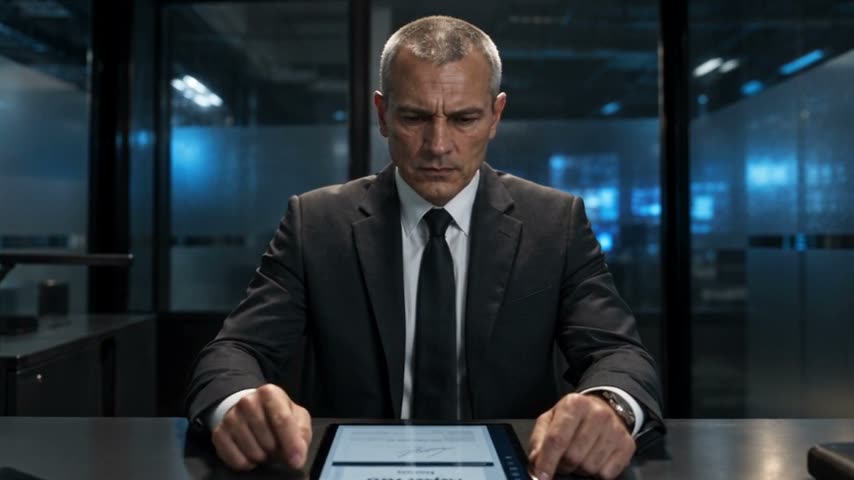
@Image1) de la toma siguiente.- Al generar, activa Return Last Frame (si tu plataforma lo ofrece) para obtener el último cuadro. Si no, extráelo del video (cualquier editor permite exportar un fotograma).
- En la toma siguiente súbelo como primera referencia, antes del personaje y la escena.
- En el prompt indica que la toma empieza exactamente en ese cuadro, sin corte de entrada y sin reencuadrar.
Así el montaje se ve continuo, como si fuera una sola cámara.
La plantilla de prompt
Orden de subida: @Image1 = último cuadro de la toma anterior (solo si continúa una toma) · @Image2 = imagen del personaje · @Image3 = imagen de la escena. Cambia lo que está entre corchetes.
@Image1 es el fotograma con el que arranca esta toma: empieza exactamente en él y continúa desde ahí, sin corte de entrada y sin reencuadrar.
@Image2 es [NOMBRE]: su cara, su pelo, su cuerpo y su ropa son exactamente los de esta imagen en toda la toma; no uses su fondo.
@Image3 es la escena: define el lugar, la luz y dónde está cada personaje y cómo va vestido; no copies sus poses.
De 0 a 4 s: [NOMBRE] [acción con verbo].
De 4 a 8 s: [acción con verbo].
En toda la toma: una sola persona en cuadro, nadie se duplica, nadie mira a cámara, sin texto en pantalla.Si es la primera toma de la escena (no hay cuadro anterior), quita la primera línea y renumera: personaje = @Image1, escena = @Image2.
| Regla | Por qué |
|---|---|
| Cada tramo lleva un verbo de acción | «Está pensativo» es un estado: el modelo lo rellena inventando. «Baja la mirada y apoya las manos» es una instrucción. |
| Lo que no quieres, no lo nombres | Escribir «sin sombrero» mete la idea de sombrero. Mejor describe lo que sí pasa. |
| Tramos de 4 s como máximo | Tramos largos dejan al modelo decidir el orden de las acciones. |
| Una persona por imagen de personaje | Si el retrato trae a dos personas, el modelo puede mezclar sus caras. |
Errores que rompen la consistencia
- Describir la cara en el texto además de subir la imagen. Dos fuentes que no coinciden = una cara intermedia.
- Retrato con fondo o luz de otra escena. Se cuela en tus tomas.
- Cambiar de ropa «por texto». Para otra ropa, otra imagen del personaje.
- Una imagen de escena distinta en cada toma del mismo lugar. Cambian los muebles y la luz.
- Empezar cada toma desde cero. Sin el último cuadro, el montaje salta.
- Prompts de un párrafo. Mejor tramos cortos con verbos.
Lista de revisión antes de generar
- ☐ La imagen del personaje es de frente, con fondo liso, luz neutra y la ropa de esta escena.
- ☐ La imagen de la escena muestra el escenario, sus elementos, la iluminación y el sitio de cada personaje.
- ☐ Si la toma continúa otra, subí el último cuadro como
@Image1. - ☐ El prompt dice qué es cada
@Imagey qué tomar de ella. - ☐ El texto solo describe acciones, por tramos de tiempo y con verbos.
- ☐ No describí la cara ni la ropa en el texto.
Deja de describir a tu personaje con palabras: la cara se la da una imagen. Una imagen del personaje, una imagen de la escena, nómbralas en el prompt y al texto déjale solo la acción. Y para encadenar las tomas, el último cuadro de un clip es el primer cuadro del siguiente.